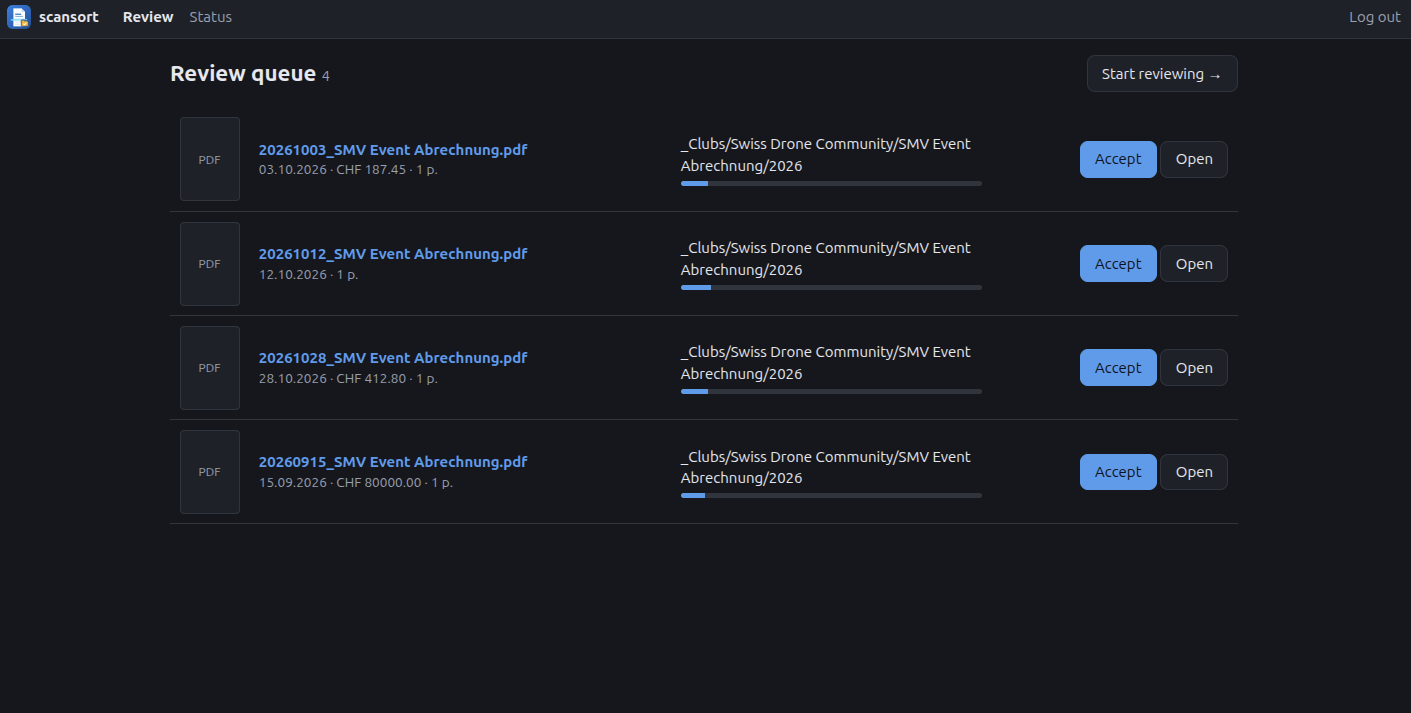
Rechnungen, Versicherungspolicen, Steuerunterlagen, Verträge - der Papierberg wird nicht kleiner. Mein Scanner kann zwar schon lange per SFTP scannen, aber danach musste ich jedes PDF von Hand anschauen, umbenennen und in den richtigen Ordner in meiner Nextcloud verschieben. Genau diesen Teil übernimmt jetzt scansort2nextcloud.
Der Ablauf ist simpel: Der Scanner lädt das PDF per SFTP hoch, scansort erkennt die neue Datei, macht bei Bedarf eine Texterkennung (OCR mit Tesseract via OCRmyPDF, Deutsch und Englisch) und liest das Dokumentdatum, den Absender und allfällige Beträge in CHF oder EUR aus. Anschliessend schlägt ein Klassifikator die drei wahrscheinlichsten Zielordner vor und generiert einen sprechenden Dateinamen wie 2026-01-05_CSS_Krankenkasse.pdf. Das PDF landet zuerst in einem _Review-Ordner in der Nextcloud, und in einem kleinen Web-UI bestätige ich den Vorschlag mit einem Klick. Danach wird die Datei serverseitig an ihren finalen Platz verschoben - Datei-ID, Versionen und Freigaben bleiben dabei erhalten.
Das Spannende daran: scansort lernt aus meiner bestehenden Ordnerstruktur. Jede Nacht synchronisiert es die Texte der bereits abgelegten PDFs und trainiert das Modell neu (TF-IDF mit Logistischer Regression aus scikit-learn, robust gegen OCR-Fehler). Jedes Dokument, das ich ablege, macht die Vorschläge also besser. Jahresordner wie Steuern/2024 und Steuern/2025 werden dabei als ein Ordner Steuern/{Jahr} erkannt und bei Bedarf automatisch angelegt.
Mir war wichtig, dass keine Daten mein Netzwerk verlassen. OCR und Klassifizierung laufen komplett lokal auf der CPU, es braucht weder GPU noch LLM noch eine externe API. Und es wird nie etwas automatisch abgelegt - der Mensch hat immer das letzte Wort. Wer eine ausgewachsene Dokumentenverwaltung wie paperless-ngx möchte, ist dort besser aufgehoben. Wer aber Nextcloud als einzige Quelle für seine Dokumente behalten will, für den ist scansort gedacht.
Das Ganze läuft als ein einziger Container (amd64 und arm64) zusammen mit einem kleinen FTP-Server (SFTPGo), optional auch mit unsicherem FTP oder FTPS. Für die Nextcloud verwendet scansort einen eigenen Benutzer mit App-Passwort, das Web-UI ist mit Passwort, CSRF-Schutz und Login-Throttling abgesichert. Doppelte Scans werden anhand einer Prüfsumme erkannt, und mit Regex-Regeln kann man bestimmte Dokumente fix einem Ordner zuweisen.
Code, Doku und das Container-Image gibt es wie immer auf GitHub (MIT-Lizenz).